llms.txt explicado para empresas: como preparar seu site para os rastreadores de inteligência artificial
Este guia traz o llms.txt explicado para empresas de forma direta: o que é o arquivo, por que ele surgiu e como criá-lo na prática. O llms.txt é um arquivo de texto padronizado em formato Markdown, hospedado na raiz dos servidores web (/llms.txt), desenvolvido para fornecer um resumo limpo, conciso e estruturado das informações essenciais de uma empresa diretamente aos modelos de linguagem de inteligência artificial (LLMs), reduzindo o consumo de tokens e evitando alucinações sobre a marca.
Conceito central
O llms.txt não substitui o arquivo robots.txt e não bloqueia robôs. Ele funciona como uma apresentação executiva para inteligências artificiais, permitindo que o modelo compreenda o propósito da sua marca em frações de segundo sem a necessidade de processar gigabytes de código HTML irrelevante.
O que é o arquivo llms.txt e por que ele surgiu?
O protocolo llms.txt nasceu para resolver um problema crescente: os modelos de linguagem de inteligência artificial precisam de informação limpa e condensada para entender uma marca com precisão, sem processar o excesso de código HTML irrelevante de um site.
O que é
O llms.txt surgiu como resposta à necessidade de padronizar a comunicação entre sites corporativos e os rastreadores de inteligência artificial (GPTBot, ClaudeBot, PerplexityBot). O protocolo segue a especificação técnica do padrão llms.txt, proposta por Jeremy Howard em 2024. Para o llms.txt explicado para empresas, o arquivo oferece uma apresentação executiva da marca em Markdown, na raiz do domínio, reduzindo o consumo de tokens e evitando alucinações.
Markdown
Os modelos de linguagem interpretam o Markdown de forma estruturada, mapeando hashtags (#, ##) como hierarquia de seções, listas de marcadores como catálogos e links absolutos como fontes canônicas. No llms.txt explicado para empresas, isso permite que o modelo compreenda o propósito da marca em frações de segundo, sem processar gigabytes de HTML irrelevante.
A diferença crucial entre robots.txt e llms.txt
Embora ambos fiquem na raiz do domínio, eles cumprem papéis diferentes. O robots.txt instrui os robôs de busca sobre o que rastrear; o llms.txt entrega conteúdo condensado para os modelos de IA processarem. Veja o comparativo:
| Critério | Protocolo robots.txt | Protocolo llms.txt |
|---|---|---|
| Objetivo principal | Instruir robôs de busca sobre quais páginas podem ou não ser rastreadas | Entregar conteúdo condensado em Markdown para processamento por LLMs |
| Público-alvo | Rastreadores tradicionais (Googlebot, Bingbot) | Motores de IA e sistemas RAG (OpenAI, Anthropic, Google) |
| Formato dos dados | Diretivas técnicas simples (User-agent, Disallow, Allow) | Texto estruturado com títulos, resumos e links em Markdown |
| Localização | Raiz do domínio: /robots.txt | Raiz do domínio: /llms.txt |
Atenção técnica
Não insira termos promocionais subjetivos ou adjetivos vazios dentro do seu llms.txt. Os modelos de linguagem atribuem maior confiabilidade a declarações factuais, números objetivos e sínteses limpas sobre os serviços prestados pela organização.
Benefícios estratégicos do llms.txt explicado para empresas
Adotar o llms.txt posiciona sua marca para ser interpretada com precisão pelos motores generativos de inteligência artificial — OpenAI ChatGPT, Google Gemini e Perplexity AI. Para o llms.txt explicado para empresas, isso garante citações qualificadas e reduz o risco de a IA inventar informações sobre o seu negócio.
-
Resumo limpo e estruturado
Entrega um resumo limpo e conciso das informações essenciais da empresa aos modelos de linguagem.
-
Menor consumo de tokens
Condensa o conteúdo em Markdown e reduz o consumo de tokens no processamento.
-
Menos alucinações
Com informações factuais, evita alucinações sobre a marca e serviços inexistentes.
-
Citações em motores de IA
Posiciona o portal para ser citado no ChatGPT, Gemini e Perplexity.
Estrutura padrão: como criar e hospedar o llms.txt explicado para empresas
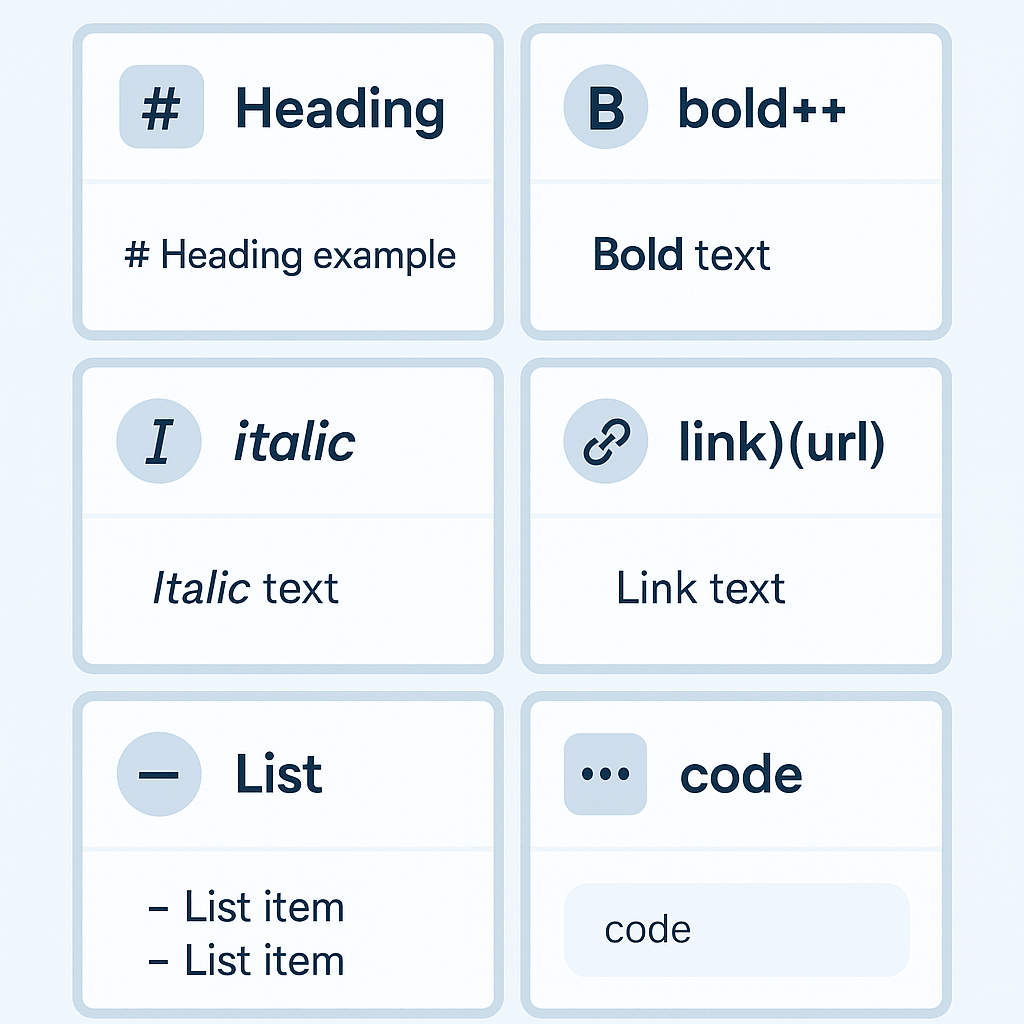
Para o llms.txt explicado para empresas funcionar, o arquivo deve ficar na raiz pública do domínio, acessível em /llms.txt, em Markdown padrão com seções claras, listas de marcadores, links absolutos e resumos curtos. A implementação deve respeitar os padrões de performance e acessibilidade na web para garantir que o arquivo e o site sejam lidos corretamente.
Informações institucionais e proposta de valor
Comece com o nome da organização, uma descrição objetiva em uma ou duas frases e a proposta de valor central. Os LLMs atribuem maior confiabilidade a declarações factuais — o mesmo princípio do conceito de Generative Engine Optimization.
Resumo de produtos e serviços corporativos
Liste em Markdown os produtos e serviços com títulos descritivos e links absolutos. Catálogos estruturados ajudam o modelo a mapear o portfólio com precisão — como a criação de sites preparados estruturalmente para IA.
Links canônicos e arquitetura de documentação
Encerre com uma seção de documentação apontando para os canônicos do domínio. Links absolutos funcionam como fontes verificáveis — a estratégia técnica de otimização para motores generativos usa essa hierarquia para consolidar autoridade.
# Obla Digital > Agência de sites, SEO e GEO para PMEs. Obla Digital é uma agência especializada em criação de sites otimizados para IA, Generative Engine Optimization (GEO), SEO técnico e arquitetura semântica para pequenas e médias empresas. ## Produtos e serviços - Criação de sites preparados estruturalmente para IA - Generative Engine Optimization (GEO) - SEO técnico e de conteúdo - Arquitetura semântica e dados estruturados (JSON-LD) ## Documentação - [O que é GEO](https://obladigital.com.br/o-que-e-geo/) — conceito de Generative Engine Optimization - [GEO para ChatGPT](https://obladigital.com.br/seo-para-chatgpt/) — otimização para motores generativos - [Agência de GEO](https://obladigital.com.br/agencia-de-geo/) — estratégia técnica completa ## Contato - WhatsApp: https://wa.me/5511991579669 # fim do arquivo
Erros críticos ao implementar o llms.txt
Falhas simples fazem o llms.txt explicado para empresas perder credibilidade com os modelos de linguagem ou gerar respostas desatualizadas sobre a empresa. Veja cada erro, um exemplo do problema e a correção na prática.
Adjetivos promocionais vazios
Termos subjetivos como "melhor empresa" ou "soluções incríveis" reduzem a confiabilidade percebida pelos LLMs.
"Somos a melhor agência de marketing digital do Brasil, com soluções incríveis."
Use números objetivos, fatos verificáveis e sínteses limpas dos serviços prestados.
"A Obla Digital é uma agência de sites, SEO e GEO voltada a PMEs, com projetos de otimização para IA."
Espelhar o site inteiro no arquivo
O llms.txt não é uma cópia do site — é uma apresentação executiva. Repetir todo o HTML derrota o propósito de reduzir tokens.
<html><body><h1>Bem-vindo</h1>... todo o HTML do site copiado para cá ...
Entregue um condensado em Markdown com seções (#, ##) e links absolutos para o aprofundamento.
## Serviços - Criação de sites otimizados para IA - Generative Engine Optimization (GEO)
Nunca atualizar o conteúdo
Um arquivo desatualizado faz a IA responder com serviços, contatos e endereço antigos, prejudicando a decisão do cliente.
## Contato - Endereço e telefone desatualizados desde 2021.
Revise o llms.txt sempre que o site mudar — novos serviços, telefones e endereços entram ali primeiro.
## Contato - Revisão mensal do arquivo + atualização imediata quando o site muda.
Ignorar a consistência com robots.txt e JSON-LD
O llms.txt precisa estar alinhado ao robots.txt e aos dados estruturados para os rastreadores de IA acessarem o que foi declarado.
# robots.txt User-agent: * Disallow: /llms.txt + JSON-LD com serviços divergentes
Confirme que as permissões de rastreamento e o JSON-LD refletem exatamente o que o arquivo comunica à IA.
# robots.txt User-agent: * Allow: /llms.txt + JSON-LD alinhado ao que o arquivo declara
Perguntas frequentes sobre o protocolo llms.txt
As dúvidas mais comuns sobre a implementação do arquivo — respondidas de forma direta para você aplicar o protocolo com segurança na sua empresa.
Ter um arquivo llms.txt garante que o ChatGPT recomendará minha empresa?
Não garante a recomendação direta de forma isolada, mas assegura que, quando o modelo consultar seu domínio, ele absorverá com precisão absoluta sua proposta comercial, evitando que a IA invente serviços que sua empresa não oferece.
Onde o arquivo llms.txt deve ser hospedado?
O arquivo deve estar alocado diretamente no diretório raiz público do site corporativo, sendo acessível pelo caminho absoluto https://seusite.com.br/llms.txt.
Qual é o formato correto de escrita para o llms.txt?
A sintaxe obrigatória é Markdown padrão, contendo seções claras delimitadas por hashtags (#, ##), listas de marcadores, links absolutos e resumos curtos em formato de parágrafos diretos.
O Google utiliza o llms.txt para ranqueamento no buscador tradicional?
O algoritmo central do Google tradicional continua utilizando o rastreamento via HTML e JSON-LD. Contudo, seus módulos generativos e assistentes com IA processam ativamente sínteses condensadas para respostas rápidas.
Marcas de qualquer segmento precisam de um llms.txt?
Qualquer negócio ou organização que deseje ter sua autoridade, histórico e catálogo de soluções interpretados com precisão por agentes inteligentes em 2026 deve implementar esse protocolo técnico preventivamente.
Como a Obla Digital implementa arquitetura semântica para empresas
Na prática, a Obla Digital aplica um processo de quatro etapas para que o site da sua empresa seja interpretado com precisão tanto pelos buscadores tradicionais quanto pelos motores generativos de inteligência artificial.
Auditoria e mapeamento semântico
Análise da hierarquia de headings H1 a H3, das palavras-chave e da intenção de busca de cada página para estruturar o conteúdo em camadas de autoridade.
Dados estruturados com JSON-LD
Implementação de Schema TechArticle, Organization e FAQPage validados, conectando o conteúdo do artigo ao contexto semântico da marca.
Consistência com robots.txt e llms.txt
Alinhamento das permissões de rastreamento e do conteúdo condensado em Markdown entregue aos rastreadores de IA (GPTBot, ClaudeBot, PerplexityBot).
Monitoramento e atualização contínua
Revisão periódica do arquivo, controle da densidade de palavras-chave e manutenção do score verde no Rank Math para manter a autoridade tópica.
Resultado na prática
Com a arquitetura semântica aplicada, o site da sua empresa é compreendido com precisão por ChatGPT, Gemini e Perplexity: o llms.txt apresenta a marca em Markdown, o JSON-LD valida os dados estruturados e os headings organizam a hierarquia de conteúdo para os agentes inteligentes.